SQL之nvl()函数
SQL之nvl()函数
2017-07-27 14:28:41 更多
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。本文链接:https://blog.csdn.net/qq_20989105/article/details/76187548
如果你某个字段为空,但是你想让这个字段显示0,而不是空,
1 | nvl(字段名,0)1 |
就是当你选出来的时候,这个字段虽然为空,但是显示的是0,当然这个0也可以换成其他东西,如:1,2,3……
SQL中的cast()函数
2017-11-27 10:46:16 更多
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。本文链接:https://blog.csdn.net/qq_21101587/article/details/78642423
CAST函数用于将某种数据类型的表达式显式转换为另一种数据类型。CAST()函数的参数是一个表达式,它包括用AS关键字分隔的源值和目标数据类型。
语法:CAST (expression AS data_type)
expression:任何有效的SQServer表达式。
AS:用于分隔两个参数,在AS之前的是要处理的数据,在AS之后是要转换的数据类型。
data_type:目标系统所提供的数据类型,包括bigint和sql_variant,不能使用用户定义的数据类型。
可以转换的类型是有限制的。这个类型可以是以下值其中的一个:
- 二进制,同带binary前缀的效果 : BINARY
- 字符型,可带参数 : CHAR()
- 日期 : DATE
- 时间: TIME
- 日期时间型 : DATETIME
- 浮点数 : DECIMAL
- 整数 : SIGNED
- 无符号整数 : UNSIGNED
例子:
1.SELECT CAST(‘9.0’ AS decimal) 结果:9

2.SELECT CAST(‘9.5’ AS decimal(10,2)) 结果:9.5(精度与小数位数分别为10与2。精度是总的数字位数,包括小数点左边和右边位数的总和。而小数位数是小数点右边的位数)

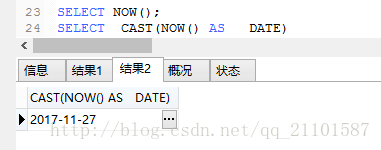
3.SELECT CAST(NOW() AS DATE) 结果:2017-11-27
now() 2017-11-27 10:43:22
SQL Server DATEDIFF() 函数
定义和用法
DATEDIFF() 函数返回两个日期之间的时间。
语法
1 | DATEDIFF(datepart,startdate,enddate) |
startdate 和 enddate 参数是合法的日期表达式。
datepart 参数可以是下列的值:
| datepart | 缩写 |
|---|---|
| 年 | yy, yyyy |
| 季度 | qq, q |
| 月 | mm, m |
| 年中的日 | dy, y |
| 日 | dd, d |
| 周 | wk, ww |
| 星期 | dw, w |
| 小时 | hh |
| 分钟 | mi, n |
| 秒 | ss, s |
| 毫秒 | ms |
| 微妙 | mcs |
| 纳秒 | ns |
实例
例子 1
使用如下 SELECT 语句:
1 | SELECT DATEDIFF(day,'2008-12-29','2008-12-30') AS DiffDate |
结果:
| DiffDate |
|---|
| 1 |
例子 2
使用如下 SELECT 语句:
1 | SELECT DATEDIFF(day,'2008-12-30','2008-12-29') AS DiffDate |
结果:
| DiffDate |
|---|
| -1 |
scala spark withColumn when 计算添加新列
spark 可以使用withColumn 结合 when 很方便的 根据原有列,来计算出新列,当然较复杂的计算还是要使用udf。
//when 所在包
scala> import org.apache.spark.sql.functions._
//创建加新的dataset
scala> spark.sql(“create table itxw(id int)”)
scala> spark.sql(“insert into itxw values(1),(0)”)
scala> spark.sql(“select * from itxw”).show
scala> var ds=spark.table(“itxw”)
1 | +---+ | id|+---+| 1|| 0|+---+ |
//$美元符号需要使用
scala> import spark.sqlContext.implicits._
//计算出新列
scala> ds=ds.withColumn(“newColumn”,when($”id” === 1,”true”).otherwise(“false”))
scala> ds.show
1 | +---+---------+| id|newColumn|+---+---------+| 1| true|| 0| false|+---+---------+ |
python spark RDD randomSplit 参数解释与使用详解
2018-05-04 14:56:19 dangsh_ 阅读数 3750
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。本文链接:https://blog.csdn.net/dangsh_/article/details/80193051
randomSplit(weigh , *seed):
参数:
1. weights: 是一个数组
根据weight(权重值)将一个RDD划分成多个RDD,权重越高划分得到的元素较多的几率就越大。数组的长度即为划分成RDD的数量,如
1 | rdd1 = rdd.randomSplit([0.25,0.25,0.25,0.25]) |
作用是把原本的RDD尽可能的划分成4个相同大小的RDD
需要注意的是weight数组内数据的加和应为1
2. seed: 是可选参数 ,作为random的种子
根据种子构造出一个Random类。
seed 是种子的意思,因为在电脑中实际上是无法产生真正的随机数的,
都是根据给定的种子(通常是当前时间、上几次运算的结果等),通过一个固定的计算公式来得到 下一个随机数
seed就是要求使用固定的种子来开始生成随机数。在给定相同的种子下,生成的随机数序列总是相同的
返回值:
返回一个rdd数组
代码测试
首先打开pyspark
创建一个rdd,内容是数字0-19构成的list

1 | >>> rdd = sc.parallelize(range(20)) |

接下来测试一下randomsplit方法

1 | >>> rdd1 = rdd.randomSplit([0.25,0.25,0.25,0.25]) |
可以看到将rdd1按照权重分为了4个RDD
接下来看seed的作用
两次的seed都设置为1,发现分割的结果完全相同
1 | >>> rdd1 = rdd.randomSplit([0.5,0.5],1) |
将seed设置为2,结果就不同了
1 | >>> rdd3 = rdd.randomSplit([0.5,0.5],2) |