Spark RDD
Spark RDD
一、迭代器串联
1.迭代器模式
在计算时,为了节省内存,不把所有的数据一次全部加载到内存中,有一种设计模式叫迭代器模式。
迭代器模式:在逻辑代码执行时,真正的逻辑并未执行,而是创建了新的迭代器,新的迭代器保存着对当前迭代器的引用从而形成链表,每个迭代器需要实现hasNext(),next()两个方法。当触发计算时,最后一个创建的迭代器会调用next方法,next方法会调用父迭代器的next方法。
例如:
1 | val list = List("a a", "b d", "c e") |
这个例子中it是初始迭代器,后面每个方法都会生成一个新的迭代器,但并不进行迭代计算,到最后foreach方法(类似action算子),开始执行迭代计算了。
我们依次展开:
1 | def flatMap[B](f: A => GenTraversableOnce[B]): Iterator[B] = new AbstractIterator[B] { |
flatMap方法是创建了一个AbstractIterator的匿名内部类,并实现了hasNext和next两个方法。每当调用next时,会先调用hasNext,在hasNext中,调上游的iterator的next方法获取上游这条数据的返回结果,再对这条结果执行用户传入的函数f并返回结果后,将其转换为iterator,再返回这个iterator的next的结果。
1 | def map[B](f: A => B): Iterator[B] = new AbstractIterator[B] { |
map与flatMap的代码模板一样,逻辑更简单,只是对上游的next返回结果执行用户传入的函数,再返回。
1 | def filter(p: A => Boolean): Iterator[A] = new AbstractIterator[A] { |
filter中,调用hasNext时,先调用上游iterator的hasNext,如果返回false,那么直接返回false。如果上游的hasNext返回true,就取出上游的next结果,并将用户传入的判断函数p作用在这个结果上,若为true,则退出循环,并将hdDefine置为true;若p的结果为false,则继续从上游取下一条数据让p判断。
1 | def foreach[U](f: A => U) { while (hasNext) f(next()) } |
遍历迭代器,将每个元素传给用户传入的函数f中执行。
2.RDD
RDD全称叫做弹性分布式数据集(Resilient Distributed Datasets),它是一种分布式的内存抽象,表示一个只读的记录分区(records)的集合,它只能通过其他RDD转换而创建,为此,RDD支持丰富的转换操作(如map, join, filter, groupBy等),通过这种转换操作,新的RDD则包含了如何从其他RDDs衍生所必需的信息,所以说RDDs之间是有依赖关系的。
基于RDDs之间的依赖,RDDs会形成一个有向无环图DAG,该DAG描述了整个流式计算的流程,实际执行的时候,RDD是通过血缘关系(Lineage)一气呵成的,即使出现数据分区丢失,也可以通过血缘关系重建分区,总结起来,基于RDD的流式计算任务可描述为:从稳定的物理存储(如分布式文件系统)中加载记录,记录被传入由一组确定性操作构成的DAG,然后写回稳定存储。另外RDD还可以将数据集缓存到内存中,使得在多个操作之间可以重用数据集,基于这个特点可以很方便地构建迭代型应用(图计算、机器学习等)或者交互式数据分析应用。可以说Spark最初也就是实现RDD的一个分布式系统,后面通过不断发展壮大成为现在较为完善的大数据生态系统,简单来讲,Spark-RDD的关系类似于Hadoop-MapReduce关系。
1、RDD特点
RDD表示只读的分区的数据集,对RDD进行改动,只能通过RDD的转换操作,由一个RDD得到一个新的RDD,新的RDD包含了从其他RDD衍生所必需的信息。RDDs之间存在依赖,RDD的执行是按照血缘关系延时计算的。如果血缘关系较长,可以通过持久化RDD来切断血缘关系。
1.1 分区
如下图所示,RDD逻辑上是分区的,每个分区的数据是抽象存在的,计算的时候会通过一个compute函数得到每个分区的数据。如果RDD是通过已有的文件系统构建,则compute函数是读取指定文件系统中的数据,如果RDD是通过其他RDD转换而来,则compute函数是执行转换逻辑将其他RDD的数据进行转换。

1.2 只读
如下图所示,RDD是只读的,要想改变RDD中的数据,只能在现有的RDD基础上创建新的RDD。

由一个RDD转换到另一个RDD,可以通过丰富的操作算子实现,不再像MapReduce那样只能写map和reduce了,如下图所示。
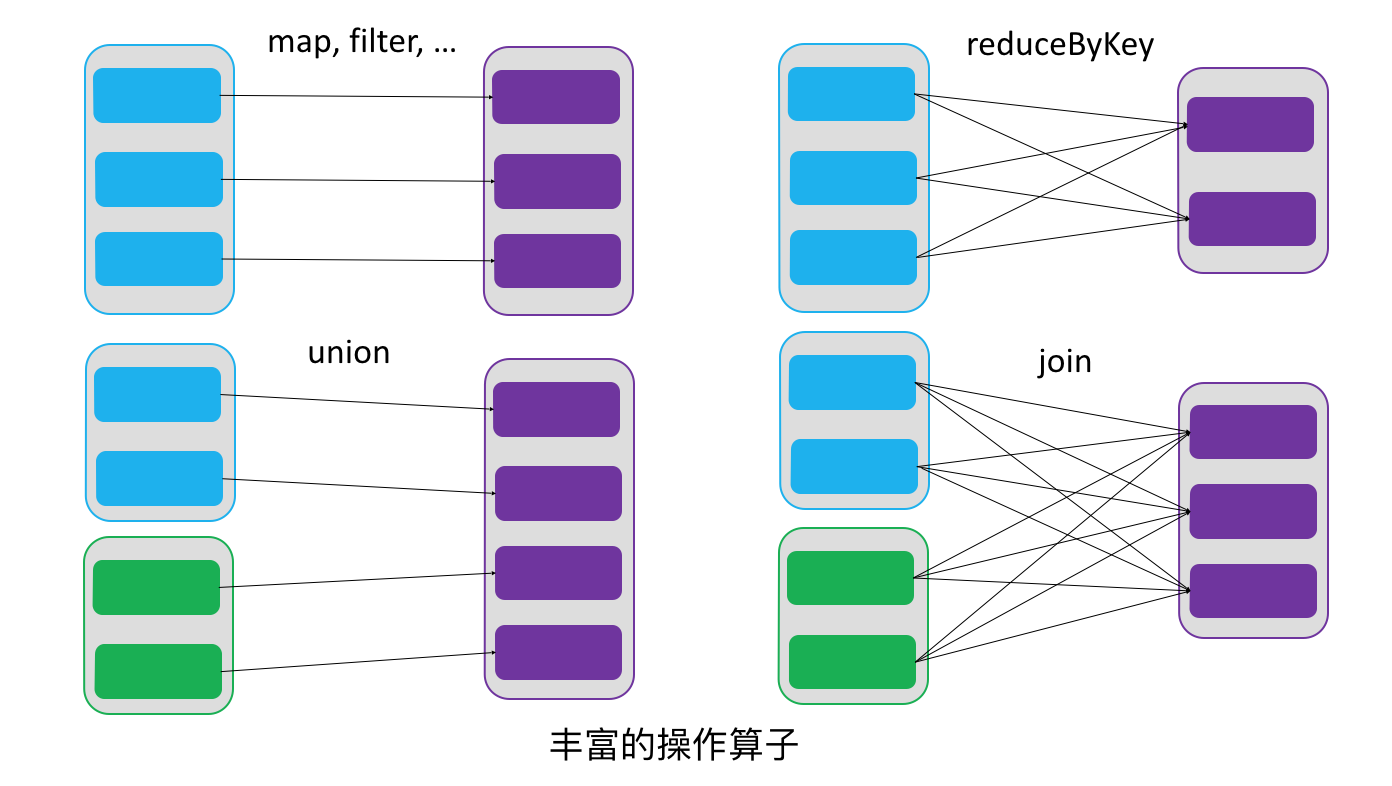
RDD的操作算子包括两类,一类叫做transformations,它是用来将RDD进行转化,构建RDD的血缘关系;另一类叫做actions,它是用来触发RDD的计算,得到RDD的相关计算结果或者将RDD保存的文件系统中。下图是RDD所支持的操作算子列表。
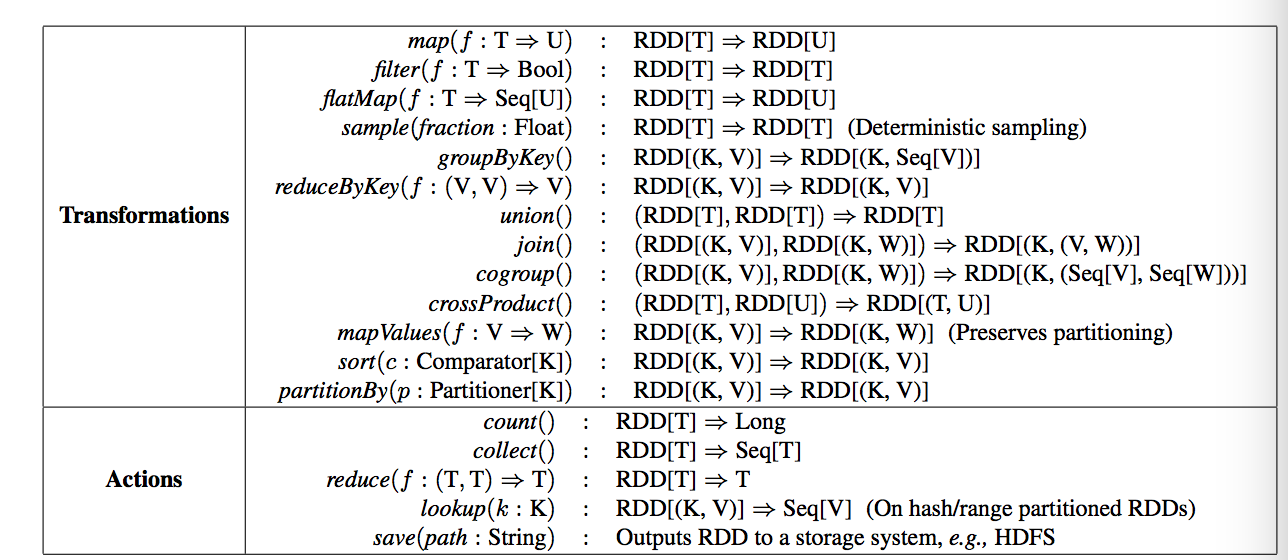 1.3 依赖
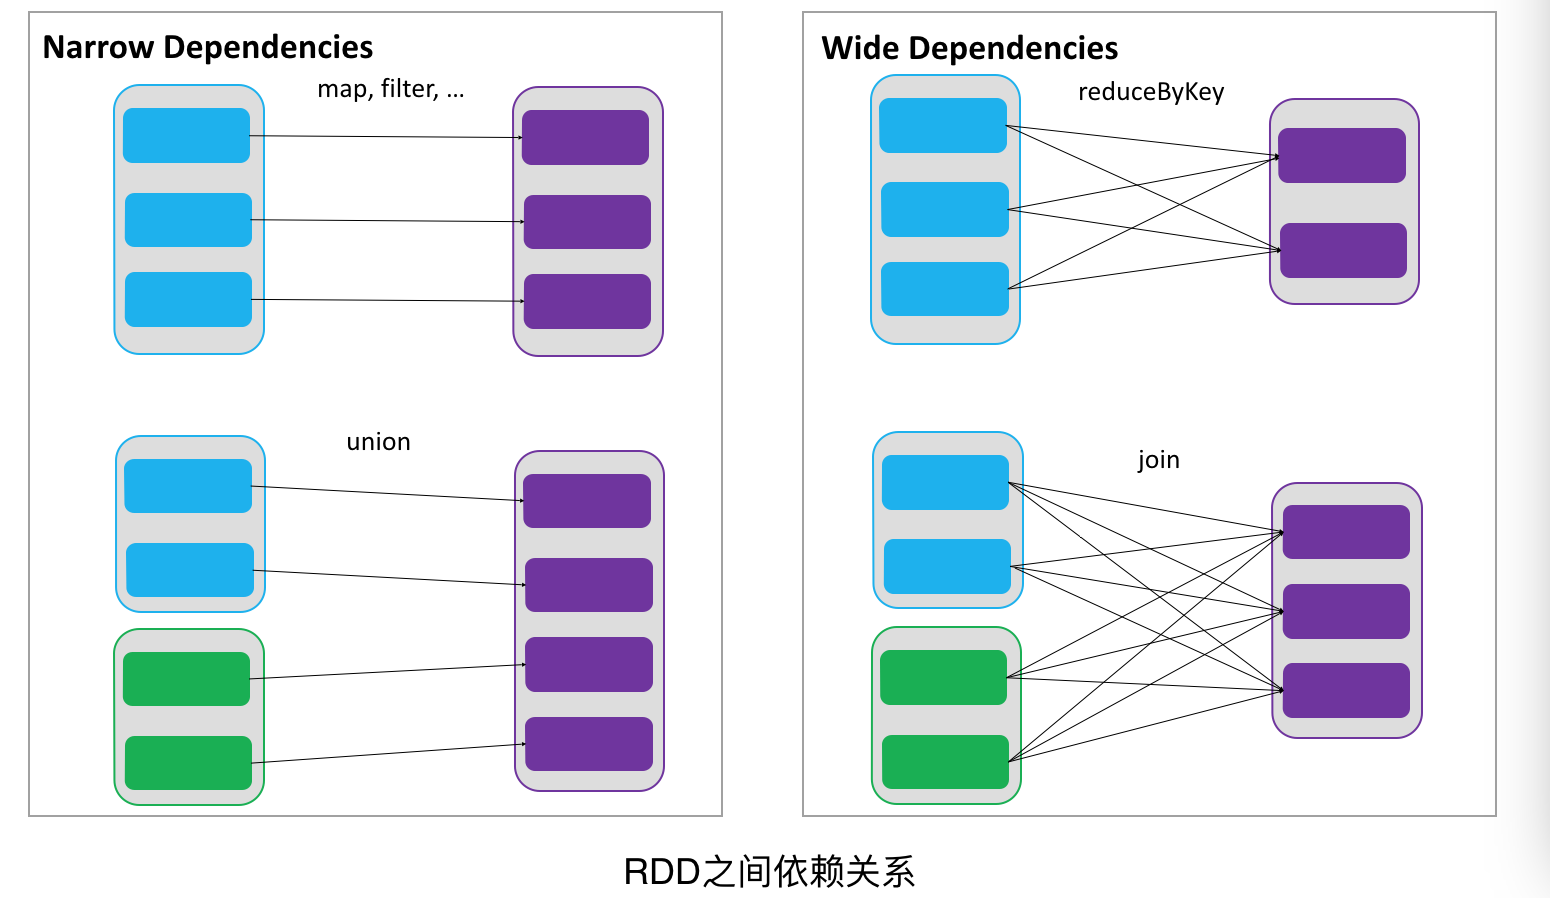
RDDs通过操作算子进行转换,转换得到的新RDD包含了从其他RDDs衍生所必需的信息,RDDs之间维护着这种血缘关系,也称之为依赖。如下图所示,依赖包括两种,一种是窄依赖,RDDs之间分区是一一对应的,另一种是宽依赖,下游RDD的每个分区与上游RDD(也称之为父RDD)的每个分区都有关,是多对多的关系。
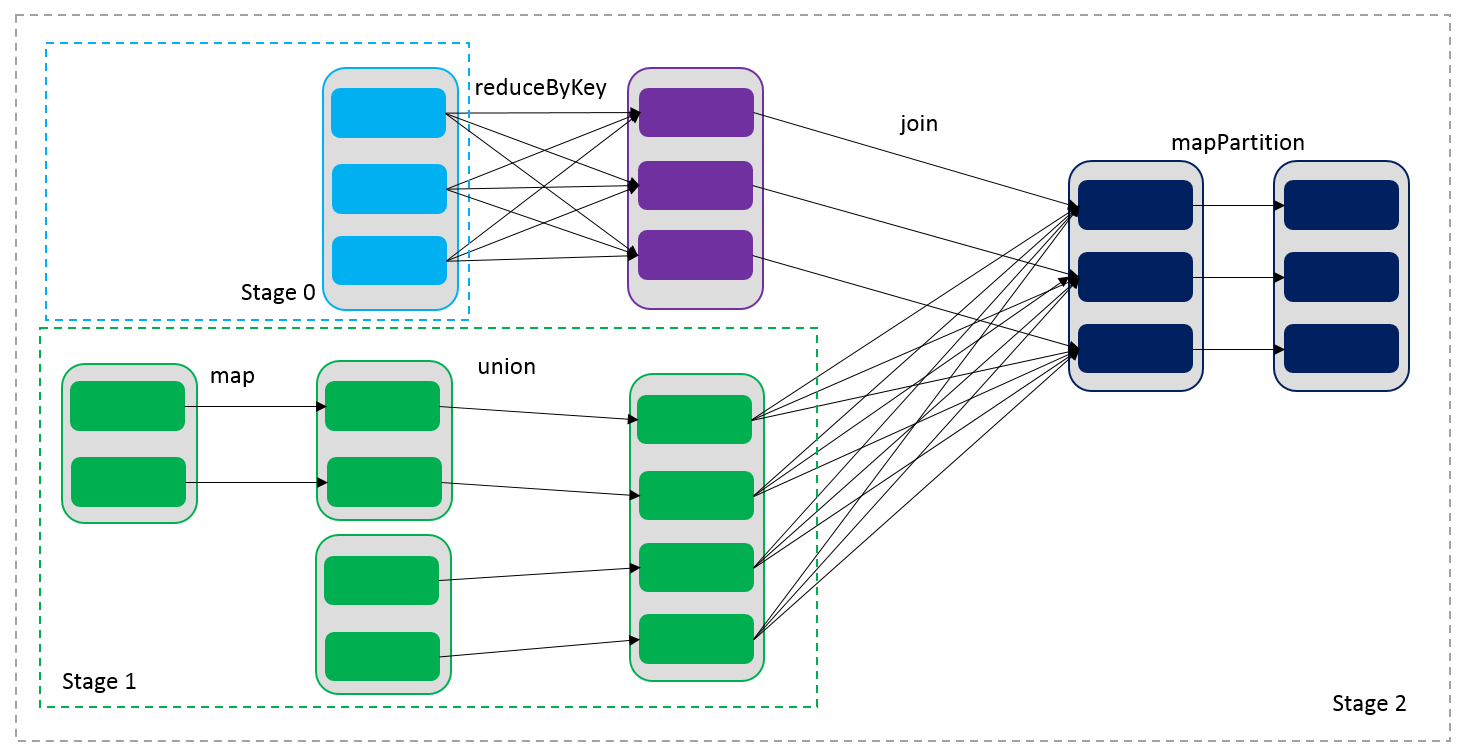
通过RDDs之间的这种依赖关系,一个任务流可以描述为DAG(有向无环图),如下图所示,在实际执行过程中宽依赖对应于Shuffle(图中的reduceByKey和join),窄依赖中的所有转换操作可以通过类似于管道的方式一气呵成执行(图中map和union可以一起执行)。
1.4 缓存
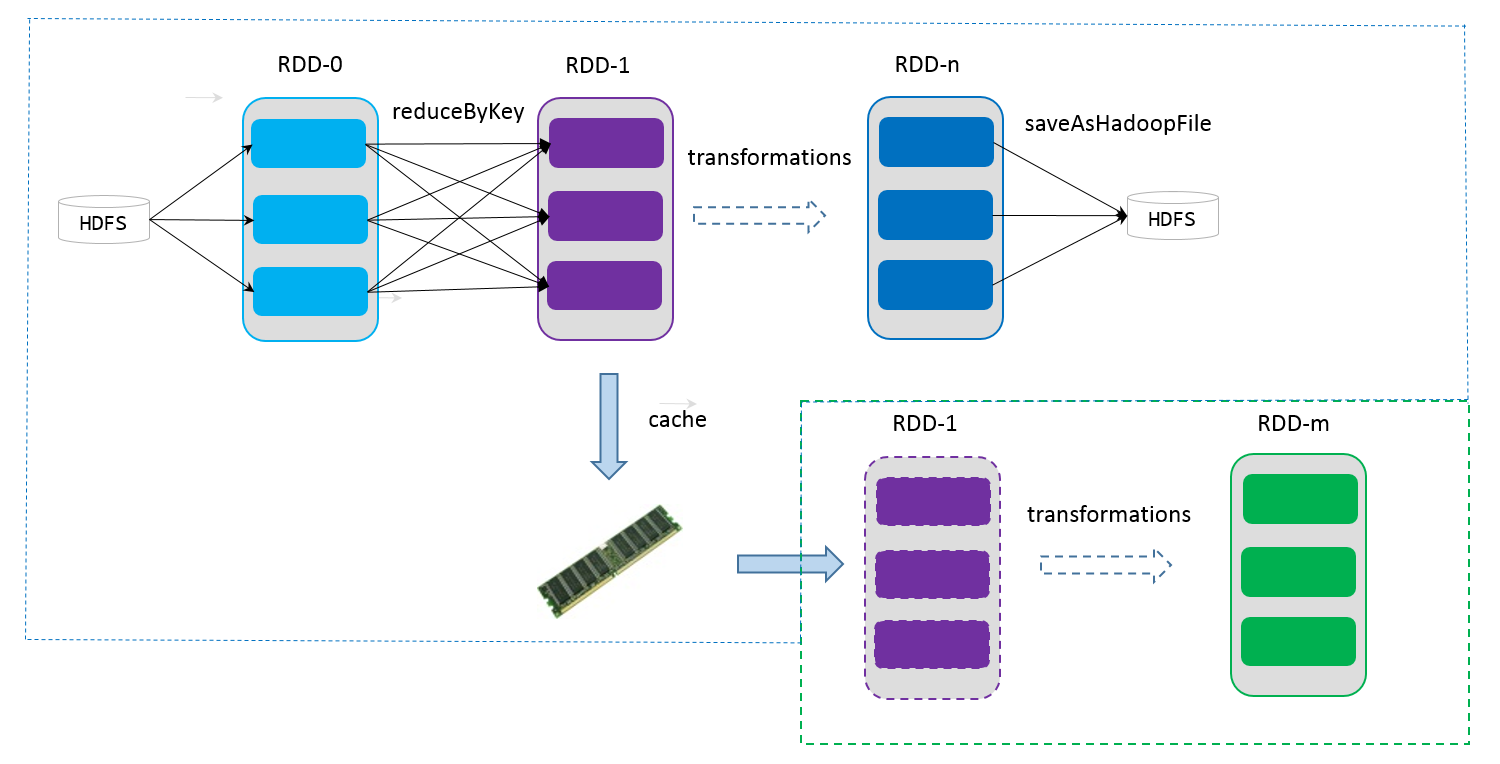
如果在应用程序中多次使用同一个RDD,可以将该RDD缓存起来,该RDD只有在第一次计算的时候会根据血缘关系得到分区的数据,在后续其他地方用到该RDD的时候,会直接从缓存处取而不用再根据血缘关系计算,这样就加速后期的重用。如下图所示,RDD-1经过一系列的转换后得到RDD-n并保存到hdfs,RDD-1在这一过程中会有个中间结果,如果将其缓存到内存,那么在随后的RDD-1转换到RDD-m这一过程中,就不会计算其之前的RDD-0了。
1.5 checkpoint
虽然RDD的血缘关系天然地可以实现容错,当RDD的某个分区数据失败或丢失,可以通过血缘关系重建。但是对于长时间迭代型应用来说,随着迭代的进行,RDDs之间的血缘关系会越来越长,一旦在后续迭代过程中出错,则需要通过非常长的血缘关系去重建,势必影响性能。为此,RDD支持checkpoint将数据保存到持久化的存储中,这样就可以切断之前的血缘关系,因为checkpoint后的RDD不需要知道它的父RDDs了,它可以从checkpoint处拿到数据。
1.6 小结
总结起来,给定一个RDD我们至少可以知道如下几点信息:
分区数以及分区方式;
由父RDDs衍生而来的相关依赖信息;
计算每个分区
的数据,计算步骤为:
- 如果被缓存,则从缓存中取的分区的数据;
- 如果被checkpoint,则从checkpoint处恢复数据;
- 根据血缘关系计算分区的数据。
2、编程模型
在Spark中,RDD被表示为对象,通过对象上的方法调用来对RDD进行转换。经过一系列的transformations定义RDD之后,就可以调用actions触发RDD的计算,action可以是向应用程序返回结果(count, collect等),或者是向存储系统保存数据(saveAsTextFile等)。在Spark中,只有遇到action,才会执行RDD的计算(即延迟计算),这样在运行时可以通过管道的方式传输多个转换。
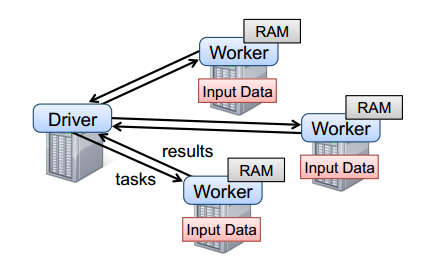
要使用Spark,开发者需要编写一个Driver程序,它被提交到集群以调度运行Worker,如下图所示。Driver中定义了一个或多个RDD,并调用RDD上的action,Worker则执行RDD分区计算任务。
3、应用举例
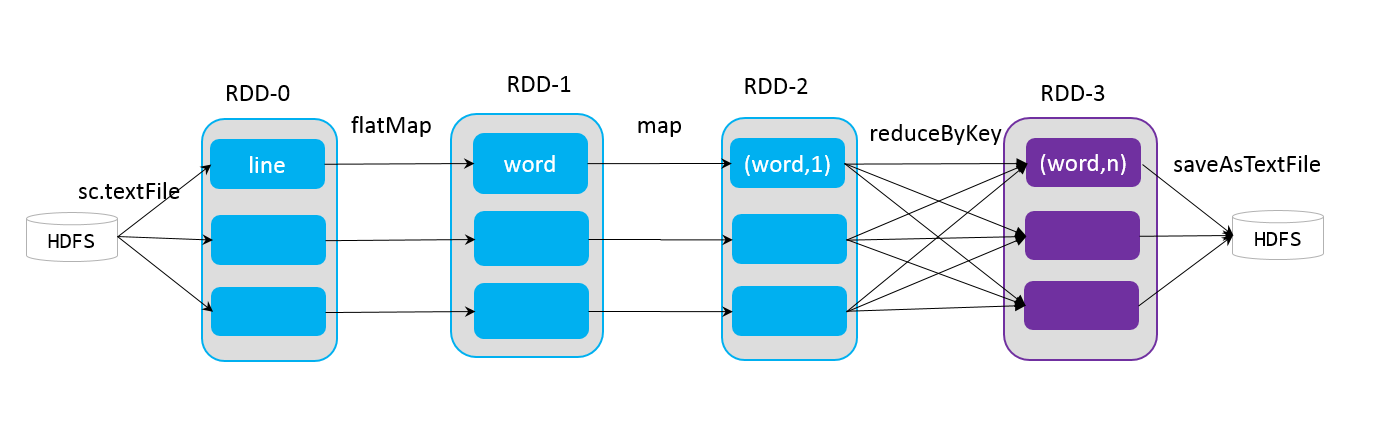
下面介绍一个简单的spark应用程序实例WordCount,统计一个数据集中每个单词出现的次数,首先将从hdfs中加载数据得到原始RDD-0,其中每条记录为数据中的一行句子,经过一个flatMap操作,将一行句子切分为多个独立的词,得到RDD-1,再通过map操作将每个词映射为key-value形式,其中key为词本身,value为初始计数值1,得到RDD-2,将RDD-2中的所有记录归并,统计每个词的计数,得到RDD-3,最后将其保存到hdfs。
1 | import org.apache.spark._ |
4、小结
基于RDD实现的Spark相比于传统的Hadoop MapReduce有什么优势呢?总结起来应该至少有三点:
- RDD提供了丰富的操作算子,不再是只有map和reduce两个操作了,对于描述应用程序来说更加方便;
- 通过RDDs之间的转换构建DAG,中间结果不用落地;
- RDD支持缓存,可以在内存中快速完成计算。
3.RDD串联
在spark的每个任务中,都是以迭代器模式进行计算的。而每个迭代器的链表对应每个分区中的数据。RDD的每个算子会生成一个新的RDD,新的RDD会保存对前一个RDD的引用,并且会保存传入到算子中的用户定义函数。
例如:
1 | def map[U: ClassTag](f: T => U): RDD[U] = withScope { |
这个map算子会返回一个MapPartitionsRDD,MapPartitionsRDD中含有当前this这个RDD的引用,并把用户定义函数f转换成作用于iterator的函数传入到MapPartitionsRDD中。
RDD中有个抽象方法compute,MapPartitionsRDD中实现如下:
1 | override def compute(split: Partition, context: TaskContext): Iterator[U] = |
从父RDD(firstParent[T])获取迭代器,这个过程需要分区信息split和任务上下文。再map算子中转换后的用户定义函数作用在这个迭代器上。
compute方法同迭代器模式类似,也是不断从上游RDD获取的迭代器,这样来获得一个迭代器的链表,这个链表就是一个task要执行的任务。
为了说明这个过程,我们从Executor源码来找寻。
1 | def launchTask(context: ExecutorBackend, taskDescription: TaskDescription): Unit = { |
Executor源码中有个launchTask方法,会创建TaskRunner,将TaskRunner交给线程池执行。TaskRunner是什么呢?
在Executor源码中有一个内部类,TaskRunner,它是一个线程的任务:
1 | class TaskRunner( |
继承Runnable必须实现run方法,找到run方法,在run方法中找到了如下代码:
1 | val res = task.run( |
点进这里task的run,会在Task类中找到runTask(context),这个runTask是Task类的抽象方法,会被Task的子类实现。比如ResultTask,这个子类是最后collect类型的action算子出发的任务类。在ResultTask中,runTask方法调用了rdd的iterator方法来获取iterator,并将用户定义的方法作用到这个iterator上。
1 | override def runTask(context: TaskContext): U = { |
这个rdd的iterator方法会获取父rdd的迭代器或调用compute方法。
1 | final def iterator(split: Partition, context: TaskContext): Iterator[T] = { |
小结
spark每个任务都是由向前依赖串联起来RDD链表生成的iterator链表构成的,任务执行由最后的一个iterator的迭代开始,调用上游的迭代器的next,直到迭代到第一个iterator。这样避免了将所有数据先加载到内存中,而每次计算都只从源头取一条数据,大大节省了内存。