计算机与服务器底层世界-CPU架构篇-Core
计算机与服务器底层世界-CPU架构篇-Core
1. 基本知识
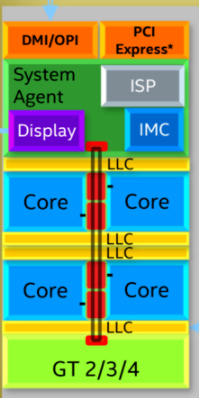
在开始之前,首先需要明确现代CPU里有多个核,比如我们经常听的四核八核等等。Core与CPU的关系图如下图所示。示意图中的CPU有四个Core(核),Core与Core之间通过Ring(环形总线)连接起来,每一个核就是一个独立的计算单元,Core本身自带L1 Cache与L2 Cache。L3是所有的Core共享。L1又划分为指令Cache与数据Cache两类。关于Cache的一些介绍,可以下滑至文末查看。本篇重点在于介绍CPU的Core里面的执行流程与部件。
2. Core架构图
话不多说,对于Skylake而言,CPU中的Core的架构图如下所示:

咋一看这个图,感觉超级复杂,各种连线,各种模块。其实对于core而言,主要目的就是执行各种运算,而剩下的就是就是core对执行运算之前的处理。对于上图,我们可以直接把Core划分为三个部分看,一个部分是前端(Front-end)也就是图中黄色的部分,另外一个就是(EU)执行单元了,也就是图中浅绿色的部分,第三块就是数据缓存,专门给执行单元提供执行指令期间所需要的数据.
2.1 Front-end(Core前端)
首先看Front-end,Front-end的主要目的就是从内存里提取各种各样的X86指令,然后对指令进行译码,融合优化等操作,把X86指令转化为最适合执行单元执行的微指令流传递给执行单元。Front-End的存在就是为了让执行单元时刻保持繁忙,将CPU的性能完全发挥出来。对于Core的Front-end模块,从上往下看,这部分主要包含:
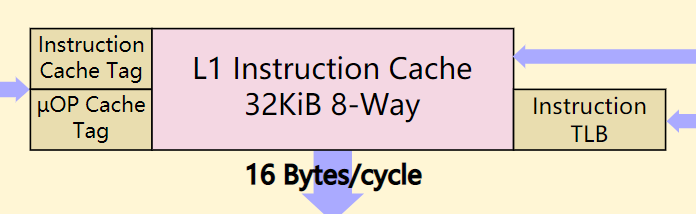
- **L1指令Cache:**缓存指令用,L1指令Cache将即将执行的指令从L2Cache中存过来供后面的流水线使用。
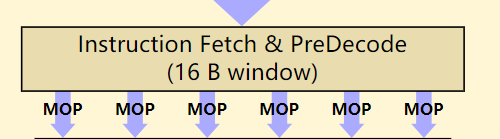
- **Instruction Fetch,PreDecode:**指令提取单元,目的是从L1中把要执行的指令拿过来并且做预解码,预解码是将一个Cacheline(64字节)的X86指令提取出来并划分边界。
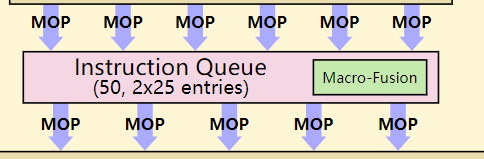
- Instruction Queue, Macro-Fusion: 指令队列与指令融合,目的是接受来自指令提取单元的指令,并把相近的X86指令融合为一条指令。
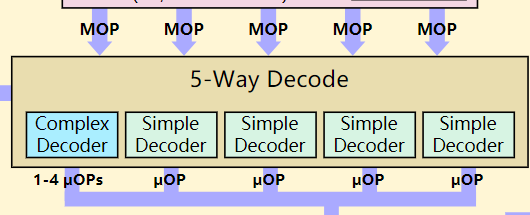
- 5-way Decode: 这里包含了五路解码器,目的将X86的可变长度的复杂指令转换为定长的微指令。五路解码器包含一个复杂的解码器与4路简单的解码器。简单解码器每次只能解码一个微指令而复杂解码器可以解码1~4个融合微指令。从图中可以看到,这个时候MOP转换成了uop。也就是可变长度的复杂指令变成了一个个定长的微码指令,这些微码指令直接给后面执行单元去执行。
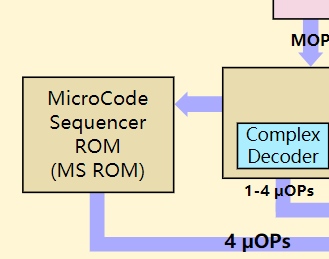
- MicroCode Sequencer ROM: 微指令排序器,对于有些复杂的指令,解析出的微指令超过4个,这个时候该指令Complex Decoder也无法解析,则会直接经过微指令排序器进行解析,MC每周期发出4uop。
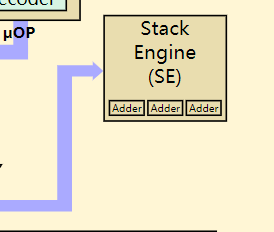
- Stack Engine: 堆栈引擎,对于程序中经常遇到的push, pop, call, ret等操作,这些操作是专门对堆栈进行操作的指令,Stack Engine会专门处理这些指令。如果没有Stack Engine,这些操作会占用ALU(算数逻辑单元)的资源,而ALU是专门用作运算的,将这些操作交给Stack Engine,ALU则可以专注运算,提升CPU的性能。
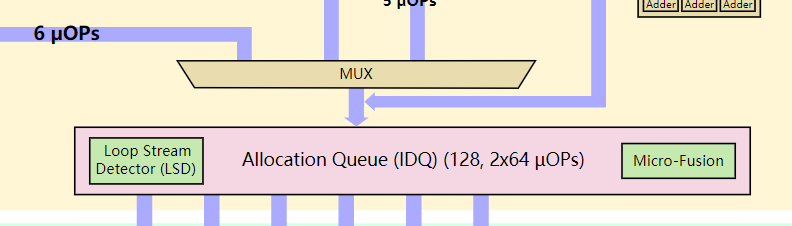
- **Decoded stream Buffer(DSB):**解码流缓冲区,准确的说就是X86指令在进行译码之后生成的微指令可以直接存在DSB里,DSB相当于也是一个Cache,只用于存储译码后的微指令.DSB的存在增强了指令的灵活性,微指令一样可以存在L1 指令Cache里,但可以经过DSB直接到达MUX。
- MUX:选择器
- **Allocation Queue(IDQ):**分配队列,分配队列作为前端与执行单元的接口,是Core前端的最后的一个部件。分配队列的目的是将微指令进行重新整合与融合,发给执行单元进行乱序执行。分配队列又包含了Loop Stream Detector(LSD) 循环流检测器,对循环操作进行优化与 up-Fusion(微指令融合单元)。融合是为了让后续解码单元更有效率并且节省ROB(re-order buffer)的空间
2.2 Execution engine (执行单元)
Front-End的存在就是为了让执行单元时刻保持繁忙,那么执行单元的最主要的目的就是执行指令,运算。这也是一个core中最根本的单元。
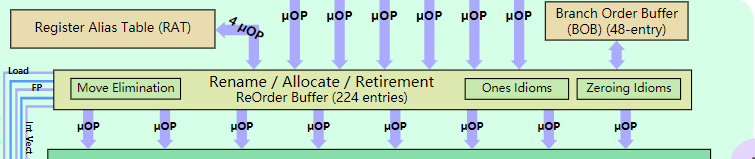
当被AQ或者IDQ(分配单元)优化过后的微指令来到执行单元时,首先最先传输到
- **ROB(re-order buffer):**重新排序缓冲区。ROB的存在ROB的目的为存储out-of-order的处理结果,作为EU的入口兼部分出口,它是乱序执行的最基本保证。当指令被传如ROB中,微指令流会以顺序执行的方式传入到后面的RS,在经过ROB时,会占用ROB的一个位置,这个位置是存储微指令乱序执行处理完成时候的结果,之后经过整合会顺序写回到相应的寄存器。而微指令在经过ROB时候会做一些优化。(消除寄存器移动,置零指令与置一指令等)。此外对于超线程中的寄存器别名技术在此经过RAT(寄存器别名表)进行寄存器重命名。
- **RS(Scheduler unified reservation station):**统一调度保留站。指令经过前面千辛万苦来到这里,此时微指令不在融合在一起,而是被单独的分配给下面各个执行单元,从架构图中可以看到,RS下面挂载了八个端口,每个端口后面挂载不同的执行模块应对不同的指令需求.
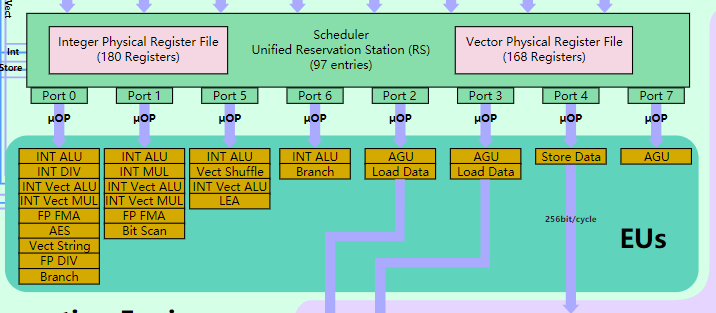
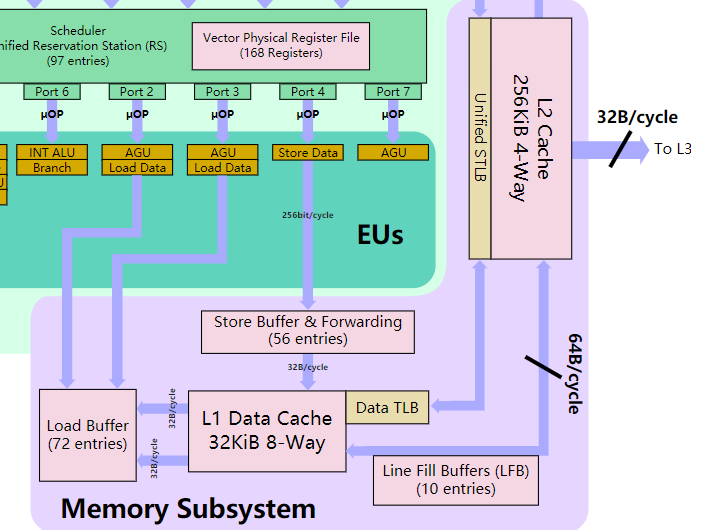
从上图中可以看到,对于8个端口,其中Port0,Port1,Port5,Port6负责各种常见运算(整数,浮点,除法,移位,AES加密,复合整数运算……),而Port2,Port3负责从下层的指令缓存提取数据,port4负责存储数据到L1缓存。Port7挂载地址生成单元(AGU address generation unit).
2.3 数据缓存系统 (L1数据缓存)
图中紫色的模块,在EU(执行单元)在执行指令时候,L1数据Cache负责供给执行指令期间所需要的数据。从图中可以看到L1数据缓存是8-路并行数据缓存,L1数据缓存可以通过数据页表地址缓存从L2提取数据与存储数据。